Base64-Konverter
Base64 dekodieren und kodieren, auch URL-safe (base64url) und MIME. „Hallo“ = SGFsbG8=. Mit Fehlerprüfung, UTF-8 und Latin-1, Hex-Ansicht und Alphabet-Tabelle.
- Format
- Base64 nach RFC 4648 Abschnitt 4
- Daten
- 5 Bytes
- Base64-Länge
- 8 Zeichen
- Größenzuwachs durch Base64
- 60 %
- Bytes (hexadezimal)
48 61 6C 6C 6F
Rechenweg mit deinen Zahlen
- 5 Bytes → 2 Blöcke à 3 Bytes → 8 Zeichen (davon 1 × „=“ als Füllung)
- Bytes: 48 61 6C 6C 6F
- Jeder 3-Byte-Block (24 Bit) wird in vier 6-Bit-Werte zerlegt; jeder Wert 0-63 ist ein Zeichen im Base64-Alphabet.
Wann nutzt du base64 encode und wann base64 decode?
Beim base64 encode wandelst du normalen Text oder Bytes in eine Base64-Zeichenfolge um. Das brauchst du zum Beispiel, wenn Daten in einem Format transportiert werden sollen, das nur gut mit sichtbaren Textzeichen umgehen kann. Aus „Hallo Welt!“ wird dann „SGFsbG8gV2VsdCE=“. Die Rechnung zeigt dazu „11 Bytes“, „16 Zeichen“ und einen Größenzuwachs von „45,5 %“.
Beim base64 decode gehst du den umgekehrten Weg: Du hast bereits eine Base64-Zeichenfolge und möchtest wieder lesbaren Text oder die ursprünglichen Bytes sehen. „SGVsbG8gd2VsdA==“ wird zum Beispiel zu „Hello welt“. Angezeigt werden dazu „10 Bytes“, „16 Zeichen“ und „60 %“ Größenzuwachs bezogen auf die ursprünglichen Daten.
Im Rechner wählst du die gewünschte Richtung, fügst die Eingabe ein und stellst bei Bedarf den Zeichensatz oder den MIME-Zeilenumbruch ein.
Merke dir die einfache Unterscheidung: Encode heißt Text zu Base64, Decode heißt Base64 zurück zu Text. Wenn dein Ergebnis nach dem Dekodieren unlesbar wirkt, ist nicht automatisch die Base64-Zeichenfolge falsch. Häufig passt nur der Zeichensatz nicht oder du hast statt normalem Base64 eine base64url-Variante vor dir.
Wie funktioniert die Rechnung bei base64 decode und encode?
Base64 verarbeitet nicht direkt Buchstaben, sondern Bytes. Die Formel lautet: Länge Base64 = 4 × ⌈Bytes ÷ 3⌉ Zeichen. In Worten: Die Daten werden in Blöcke aus je 3 Bytes zerlegt. Jeder Block wird als 24 Bit betrachtet und danach in 4 Gruppen mit je 6 Bit aufgeteilt. Jede dieser Gruppen zeigt auf ein Zeichen im Base64-Alphabet.
Das Beispiel „Hallo“ zeigt den Ablauf kompakt:
- Eingabetext: „Hallo“
- Datenmenge: „5 Bytes“
- Bytes hexadezimal: „48 61 6C 6C 6F“
- Base64-Ergebnis: „SGFsbG8=“
- Base64-Länge: „8 Zeichen“
- Größenzuwachs: „60 %“
Die Rechnung dahinter: „5 Bytes“ ergeben „2 Blöcke à 3 Bytes“. Weil der letzte Block nicht vollständig gefüllt ist, erscheint am Ende „1 × „=“ als Füllung“. Dieses Zeichen gehört also nicht zum ursprünglichen Text, sondern macht die Blockstruktur vollständig.
Beim Dekodieren läuft derselbe Mechanismus rückwärts. Die Base64-Zeichen werden wieder in ihre Werte übersetzt, daraus entstehen Bitgruppen, daraus wieder Bytes. Aus den Bytes wird anschließend Text im gewählten Zeichensatz, meist UTF-8. Deshalb kann dieselbe Bytefolge anders aussehen, wenn du den falschen Zeichensatz auswählst.
Warum wird Base64 größer als der Ursprungstext?
Base64 ist eine Darstellung, keine Komprimierung. Es verpackt Bytes in ein Textalphabet. Dadurch entstehen meist mehr Zeichen als im Original. Bei großen Daten liegt der Zuwachs oft nahe bei „33,3 %“, bei kleinen Eingaben kann er deutlich höher ausfallen, weil die Blöcke aufgefüllt werden müssen.
Ein paar Größen aus typischen Rechnungen zeigen den Unterschied:
| Originalgröße | Base64-Zeichen | Zuwachs |
|---|---|---|
| 1 Byte | 4 | 300 % |
| 2 Bytes | 4 | 100 % |
| 3 Bytes | 4 | 33,3 % |
| 10 Bytes | 16 | 60 % |
| 100 Bytes | 136 | 36 % |
| 1 kB | 1.336 | 33,6 % |
| 1 MB | 1.333.336 | 33,3 % |
Der Effekt fällt bei kurzen Texten besonders auf. „1234567890“ hat „10 Bytes“, wird aber zu „MTIzNDU2Nzg5MA==“ mit „16 Zeichen“. Das ergibt „60 %“ Zuwachs. Bei „benutzer:geheim“ sind es „15 Bytes“ und „20 Zeichen“, also „33,3 %“. Der Unterschied kommt daher, ob die Eingabe genau in die Blöcke passt oder ob Padding nötig ist.
Wenn du Base64 in E-Mails oder älteren MIME-Kontexten verwendest, kann zusätzlich ein Zeilenumbruch nach „76 Zeichen“ gesetzt werden. Das ändert die Lesbarkeit und das Transportformat, aber nicht den eigentlichen Inhalt der dekodierten Bytes.
Base64url, JWT und normale Base64-Zeichenfolgen unterscheiden
Normales Base64 und base64url sehen sehr ähnlich aus, sind aber nicht immer austauschbar. Standard-Base64 nach RFC 4648 Abschnitt 4 verwendet das Alphabet mit „A-Z, a-z, 0-9, + und /“. base64url nach RFC 4648 Abschnitt 5 ist für URL- und Token-Kontexte gedacht und wird häufig ohne Padding ausgegeben.
Ein einfaches Beispiel: Der Text „JWT Test 123“ wird als base64url zu „SldUIFRlc3QgMTIz“. Die Rechnung zeigt „12 Bytes“, „16 Zeichen“ und „33,3 %“ Zuwachs. Bei JWT-Teilen ist base64url besonders häufig. Ein JWT-Header aus dem Beispiel „eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9“ wird zu „{„alg“:„HS256“,„typ“:„JWT“}“ und hat „27 Bytes“ sowie „36 Zeichen“.
Wenn ein JWT-Teil oder ein URL-Parameter im normalen Decoder scheitert, prüfe zuerst die Variante. Besonders auffällig sind fehlende „=“-Zeichen am Ende oder Zeichen, die im URL-Kontext vorkommen. Der base64url-Modus ist dann meist die passende Wahl.
Noch ein Praxisfall: „ZXlKcGJtTnZaR1Z5SWpwYkltVjRjR2x5WlQwPQ“ wird im base64url-Modus zu „eyJpbmNvZGVyIjpbImV4cGlyZT0=“. Die Rechnung zeigt „28 Bytes“, „38 Zeichen“ und „35,7 %“ Zuwachs. Dass im dekodierten Text wieder ein „=“ auftaucht, ist kein Widerspruch. Es ist dann Teil des dekodierten Inhalts.
Typische Fehler beim Base64 dekodieren vermeiden
Der häufigste Irrtum: Base64 wird mit Verschlüsselung verwechselt. Base64 schützt nichts. Wenn du einen API-Schlüssel, ein Passwort oder einen Token in Base64 siehst, ist der Inhalt nur anders dargestellt. Wer die Zeichenfolge hat, kann sie ohne Schlüssel zurückwandeln. Für Geheimhaltung brauchst du ein anderes Verfahren.
Achte außerdem auf diese Punkte:
- Falsche Richtung: Wenn du lesbaren Text eingibst, brauchst du Encode. Wenn du eine Base64-Zeichenfolge eingibst, brauchst du Decode.
- Falsche Variante: JWTs und URL-Parameter nutzen oft base64url, nicht normales Base64.
- Falscher Zeichensatz: UTF-8 ist der übliche Standard. ISO-8859-1 passt eher zu alten Latin1-Daten.
- Padding falsch bewertet: „=“ am Ende ist häufig nur Füllung und kein Inhalt.
- Zeilenumbrüche falsch kopiert: MIME kann Zeilenumbrüche enthalten. Beim reinen Vergleich von Zeichenfolgen können sie stören.
Umlaute zeigen gut, warum der Zeichensatz zählt. „Füße, Öl und Grüße“ wird mit UTF-8 zu „RsO8w59lLCDDlmwgdW5kIEdyw7zDn2U=“. Die Rechnung meldet „23 Bytes“, obwohl der sichtbare Text weniger Zeichen enthält. Der Grund: Zeichen wie „ü“, „ß“ oder „Ö“ benötigen in UTF-8 andere Bytefolgen als einfache ASCII-Buchstaben.
Wenn du beim Dekodieren nur kryptische Zeichen erhältst, prüfe daher zuerst: Ist es wirklich Text? Ist die Variante korrekt? Passt UTF-8 oder ISO-8859-1? Erst danach lohnt sich die Suche nach einer beschädigten Eingabe.
Tabellen zum Nachschlagen
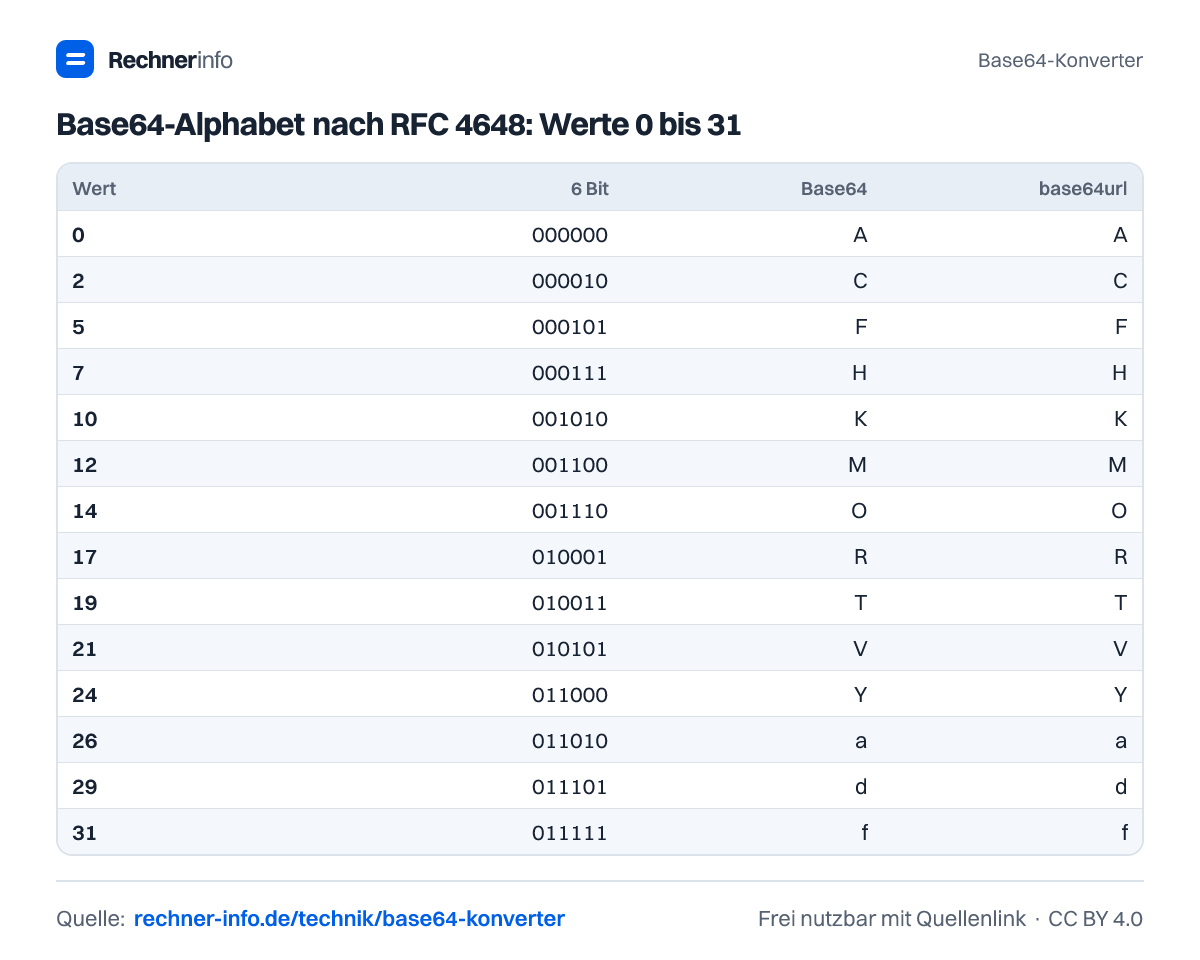
Base64-Alphabet nach RFC 4648: Werte 0 bis 31
| Wert | 6 Bit | Base64 | base64url |
|---|---|---|---|
| 0 | 000000 | A | A |
| 1 | 000001 | B | B |
| 2 | 000010 | C | C |
| 3 | 000011 | D | D |
| 4 | 000100 | E | E |
| 5 | 000101 | F | F |
| 6 | 000110 | G | G |
| 7 | 000111 | H | H |
| 8 | 001000 | I | I |
| 9 | 001001 | J | J |
| 10 | 001010 | K | K |
| 11 | 001011 | L | L |
| 12 | 001100 | M | M |
| 13 | 001101 | N | N |
| 14 | 001110 | O | O |
| 15 | 001111 | P | P |
| 16 | 010000 | Q | Q |
| 17 | 010001 | R | R |
| 18 | 010010 | S | S |
| 19 | 010011 | T | T |
| 20 | 010100 | U | U |
| 21 | 010101 | V | V |
| 22 | 010110 | W | W |
| 23 | 010111 | X | X |
| 24 | 011000 | Y | Y |
| 25 | 011001 | Z | Z |
| 26 | 011010 | a | a |
| 27 | 011011 | b | b |
| 28 | 011100 | c | c |
| 29 | 011101 | d | d |
| 30 | 011110 | e | e |
| 31 | 011111 | f | f |
Base64-Alphabet nach RFC 4648: Werte 32 bis 63
| Wert | 6 Bit | Base64 | base64url |
|---|---|---|---|
| 32 | 100000 | g | g |
| 33 | 100001 | h | h |
| 34 | 100010 | i | i |
| 35 | 100011 | j | j |
| 36 | 100100 | k | k |
| 37 | 100101 | l | l |
| 38 | 100110 | m | m |
| 39 | 100111 | n | n |
| 40 | 101000 | o | o |
| 41 | 101001 | p | p |
| 42 | 101010 | q | q |
| 43 | 101011 | r | r |
| 44 | 101100 | s | s |
| 45 | 101101 | t | t |
| 46 | 101110 | u | u |
| 47 | 101111 | v | v |
| 48 | 110000 | w | w |
| 49 | 110001 | x | x |
| 50 | 110010 | y | y |
| 51 | 110011 | z | z |
| 52 | 110100 | 0 | 0 |
| 53 | 110101 | 1 | 1 |
| 54 | 110110 | 2 | 2 |
| 55 | 110111 | 3 | 3 |
| 56 | 111000 | 4 | 4 |
| 57 | 111001 | 5 | 5 |
| 58 | 111010 | 6 | 6 |
| 59 | 111011 | 7 | 7 |
| 60 | 111100 | 8 | 8 |
| 61 | 111101 | 9 | 9 |
| 62 | 111110 | + | - |
| 63 | 111111 | / | _ |
Base64-Beispiele: Text in Base64 umwandeln
| Text | Base64 | base64url |
|---|---|---|
| a | YQ== | YQ |
| ab | YWI= | YWI |
| abc | YWJj | YWJj |
| Hallo | SGFsbG8= | SGFsbG8 |
| Hallo Welt | SGFsbG8gV2VsdA== | SGFsbG8gV2VsdA |
| Test | VGVzdA== | VGVzdA |
| test123 | dGVzdDEyMw== | dGVzdDEyMw |
| admin:passwort | YWRtaW46cGFzc3dvcnQ= | YWRtaW46cGFzc3dvcnQ |
| ä | w6Q= | w6Q |
| ü | w7w= | w7w |
| ß | w58= | w58 |
| € | 4oKs | 4oKs |
| <<???>> | PDw/Pz8+Pg== | PDw_Pz8-Pg |
Wie groß wird Base64? Bytes und Zeichen
| Originalgröße | Base64-Zeichen | Zuwachs |
|---|---|---|
| 1 Byte | 4 | 300 % |
| 2 Bytes | 4 | 100 % |
| 3 Bytes | 4 | 33,3 % |
| 10 Bytes | 16 | 60 % |
| 100 Bytes | 136 | 36 % |
| 1 kB | 1.336 | 33,6 % |
| 1 KiB | 1.368 | 33,6 % |
| 1 MB | 1.333.336 | 33,3 % |
| 1 MiB | 1.398.104 | 33,3 % |
Beispiele zum Ausprobieren
Grafiken für deine Website
Du darfst die Grafiken kostenlos in Blogs, Artikeln, Präsentationen oder im Unterricht verwenden - einzige Bedingung ist ein Link auf diese Seite als Quelle (Lizenz CC BY 4.0).
Häufige Fragen
Was ist base64 decode?
base64 decode wandelt eine Base64-Zeichenfolge zurück in Bytes und daraus, wenn möglich, in Text. „SGFsbG8gV2VsdCE=“ ergibt zum Beispiel „Hallo Welt!“. Die Rechnung zeigt dazu „11 Bytes“, „16 Zeichen“ und „45,5 %“ Größenzuwachs der Base64-Darstellung gegenüber den ursprünglichen Daten.
Wie kann ich Text in Base64 kodieren?
Du kodierst Text in Base64, indem du die Richtung Text zu Base64 wählst und den Text mit passendem Zeichensatz verarbeitest. Aus „Hallo“ wird „SGFsbG8=“. Dazu gehören „5 Bytes“, „8 Zeichen“ und „60 %“ Größenzuwachs, weil der letzte Block mit „=“ aufgefüllt wird.
Warum steht am Ende von Base64 ein Gleichheitszeichen?
Das Gleichheitszeichen ist Padding, also Füllung für den letzten Block. Bei „Hallo“ entstehen „5 Bytes“, daraus „2 Blöcke à 3 Bytes“ und „8 Zeichen“. Weil der letzte Block nicht vollständig ist, erscheint „1 × „=“ als Füllung“ im Ergebnis „SGFsbG8=“.
Ist Base64 eine Verschlüsselung?
Nein, Base64 ist keine Verschlüsselung. Es gibt keinen geheimen Schlüssel und jede passende Base64-Zeichenfolge lässt sich wieder dekodieren. Ein Basic-Auth-Text wie „benutzer:geheim“ wird zu „YmVudXR6ZXI6Z2VoZWlt“, bleibt aber inhaltlich rekonstruierbar. Base64 eignet sich für Darstellung und Transport, nicht für Geheimhaltung.
Warum wird Base64 größer?
Base64 wird größer, weil je 3 Bytes als 4 Zeichen dargestellt werden. Bei „benutzer:geheim“ sind es „15 Bytes“ und „20 Zeichen“, also „33,3 %“ Zuwachs. Bei kurzen Eingaben kann der Anteil höher sein, etwa „60 %“ bei „10 Bytes“ und „16 Zeichen“.
Was ist der Unterschied zwischen Base64 und base64url?
base64url ist eine URL-taugliche Variante von Base64 und wird häufig ohne Padding verwendet. „JWT Test 123“ wird als base64url zu „SldUIFRlc3QgMTIz“. Die Rechnung nennt „12 Bytes“, „16 Zeichen“ und „33,3 %“. Für JWT-Teile und URL-Parameter ist base64url oft die richtige Auswahl.
Warum kommt beim Base64 dekodieren unlesbarer Text heraus?
Unlesbarer Text entsteht oft durch einen falschen Zeichensatz, die falsche Base64-Variante oder dadurch, dass die dekodierten Bytes gar kein Text sind. UTF-8 ist meist passend, ISO-8859-1 eher für alte Latin1-Daten. Prüfe außerdem, ob deine Eingabe normales Base64 oder base64url ist.
Kann Base64 Umlaute wie ä, ü und ß kodieren?
Ja, Base64 kann Umlaute kodieren, wenn der Zeichensatz korrekt ist. Mit UTF-8 wird „Füße, Öl und Grüße“ zu „RsO8w59lLCDDlmwgdW5kIEdyw7zDn2U=“. Die Rechnung zeigt „23 Bytes“ und „32 Zeichen“. Umlaute belegen in UTF-8 andere Bytefolgen als einfache Buchstaben.
Quellen und Prüfung
- RFC 4648: The Base16, Base32, and Base64 Data Encodings - IETF
- RFC 2045: MIME Part One (Base64 Content-Transfer-Encoding, 76 Zeichen je Zeile) - IETF
Diese Seite zitieren
Base64-Konverter. Rechnerinfo, Stand 23.09.2026. https://rechner-info.de/technik/base64-konverter